PDFの文字を読み取る(OCR) スキャンしたPDFの文字を、コピーできる文に
English page: PDF to Text
スキャンしたPDFや、文字を選べないPDFの文字を、このページで読み取って、コピーできる文にします。文字がもう入っているPDFなら、その文字をそのまま取り出します。日本語と英語に対応。何個でも、何回でも完全無料です。登録も広告もなく、アプリも要りません。
PDFの文字を読み取る
縦書きのページがあるようです。このツールは横書き向けです。縦書きは、行の順番が崩れたり、読めなかったりします。
縦書きの本や書類のPDFは、Macのアプリヨミガエルで、読む順番どおりに文字を入れられます。Apple Silicon 搭載の Mac(M1 以降)、macOS 14(Sonoma)以降で使えます。Intel 搭載の Mac と macOS 13(Ventura)以前では使えません。
はじめてのPDFは、読み取りの準備のために約10MB(英語だけなら約8MB)の通信をするので、少し待ちます。1ページに数秒〜数十秒かかります。
ときどき読み間違えます(たとえば「日」が「目」になります)。下書きとして使い、読み返して直してください。
使い方
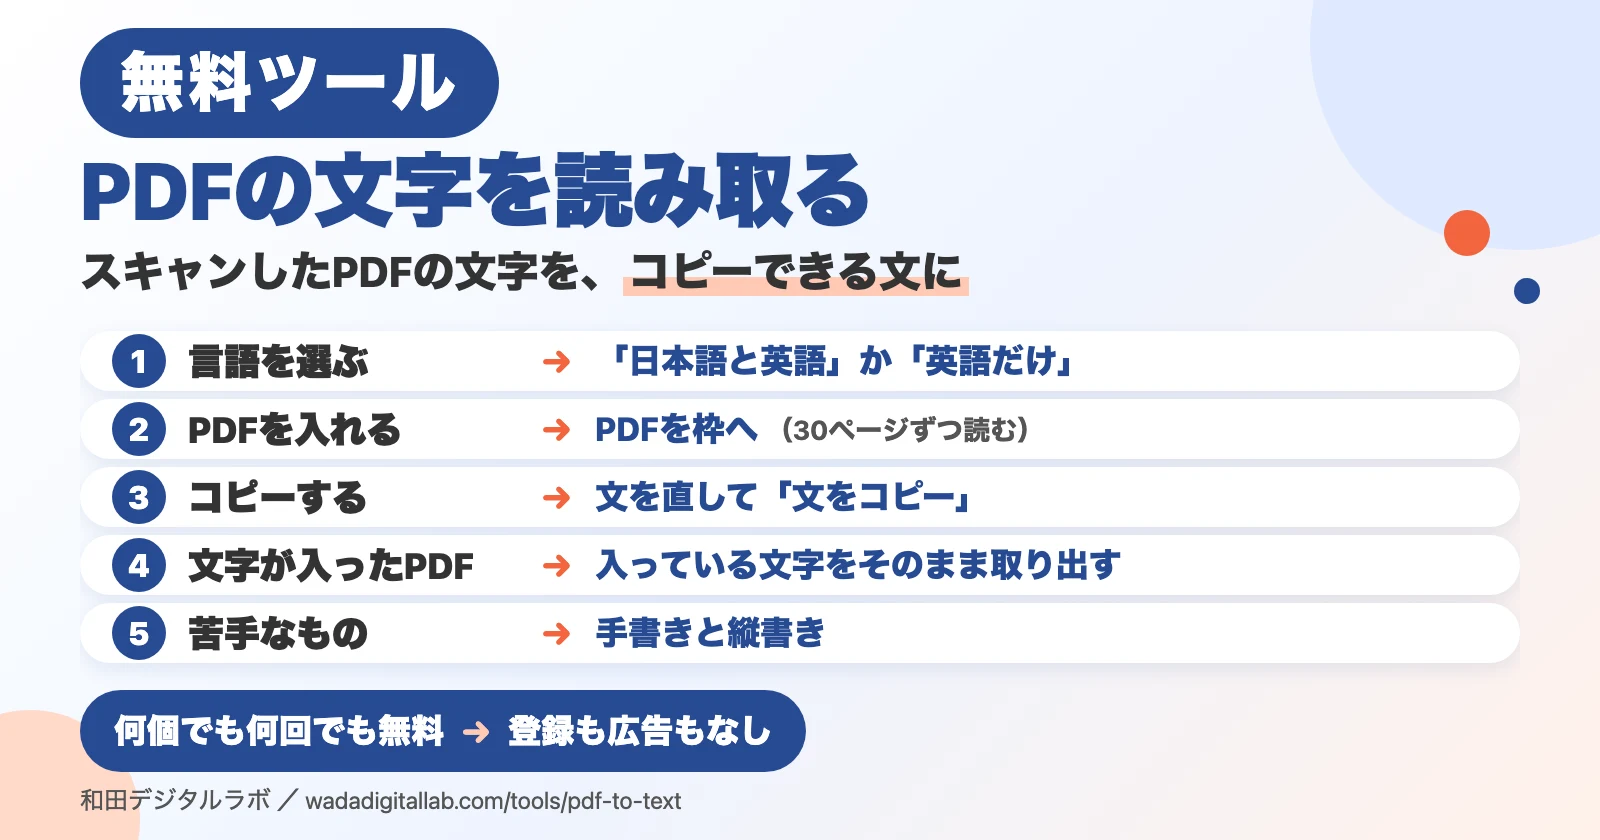
- 言語を選びます。日本語が入っているPDFなら「日本語と英語」、英語だけのPDFなら「英語だけ」です。選ぶのは、PDFを入れる前です。
- 「PDFを選ぶ」を押すか、PDFをこの枠の中へドラッグします。いくつでもまとめて入れられます。
- ページごとに読み取った文が、下に出ます。その場で直してから、「文をコピー」か「テキストで保存」を押します。31ページ以上あるPDFは、「続きの◯ページを読む」を押すと続きを読みます。
文字がもう入っているページは、その文字をそのまま取り出すので、すぐ終わります。スキャンしたページは、画像として文字を読むので時間がかかります。テキストは、元のPDFと同じ名前で、最後が「.txt」になります。元のPDFは変わりません。
きれいに読み取るコツ
- スキャンは300dpiくらいで:解像度の低いスキャンや、かすれた文字は、読み間違いが増えます。
- まっすぐスキャンする:斜めに傾いたページは、行がずれて読み間違えます。
- 英文だけなら「英語だけ」:英語のPDFは「英語だけ」を選ぶと正確になります。
- 横書きの文章向け:縦書きの本や新聞は、行の順番が崩れることがあります。
- 手書きは苦手:印刷された文字向けです。手書きは、楷書でも一部しか読めません。
よくある質問
- どういう仕組みで動きますか?
- PDFを開くプログラム(PDF.js)と、文字を読み取るプログラム(Tesseract)が、ブラウザの中で動きます。はじめてのPDFのときに、このプログラムと、日本語と英語の文字のデータを、このサイトから受け取ります(約10MB。英語だけなら約8MB)。文字がもう入っているページは、その文字を取り出します。文字が入っていないページは、画像にしてから文字の形を見分けて文にします。計算は全部、お使いのパソコンやスマホがします。
- 入れたPDFは、サーバーに送られますか?
- 送られません。このツールは、お使いのパソコンやスマホの中だけで動きます。入れたPDFも、読み取った文字も、ファイルの名前も、サーバーには一切送りません。当方が数えるのは、ページが開かれた回数、ツールが使われた回数、ページが画面に出ていた時間、ページをどこまでスクロールしたか、の4つだけです。どれにも、ファイルの名前や中身は入りません。
- 本当に無料ですか?
- はい。何個でも、何回でも無料です。登録も広告もありません。
- どんなPDFを読めますか?
- 1つ100MBまでのPDFです。一度に30ページずつ読み、続きはボタンで読みます。スキャンしたPDF、写真から作ったPDF、文字の入ったPDFのどれでも入れられます。
- パスワードの付いたPDFは読めますか?
- 読めません。開くのにパスワードが要るPDFは、先にパスワードを外してから入れてください。
- 文字がもう入っているPDFは、どうなりますか?
- 入っている文字をそのまま取り出します。ただ、ほかのアプリで入れた文字は、順番が崩れていたり、字が抜けていたりすることがあります。おかしいときは、結果の下の「全部のページを画像として読み直す」を押すと、画像から読み直します。
- 縦書きは読めますか?
- 横書き向けです。縦書きの本や新聞は、行の順番が崩れたり、読めなかったりします。縦書きのページを見つけたときは、結果の上で知らせます。
- 手書きの文字も読めますか?
- 印刷された文字向けです。手書きは、きれいな楷書なら一部読めますが、崩した字はほとんど読めません。
- 時間がかかります
- はじめてのPDFは、準備のために約10MB(英語だけなら約8MB)を読み込むので、少し待ちます。スキャンしたページは、1ページに数秒〜数十秒かかります。スマホでは、パソコンより時間がかかります。途中で止めるときは「読み取りを止める」を押してください。
- 検索できるPDFにできますか?
- このページは、読み取った文をテキストとして出すだけです。PDFの中に文字を入れて、検索やコピーができるPDFにする機能はありません。
- 写真やスクショの文字も読めますか?
- 画像から文字を読み取るのページで、PNG・JPG などの画像の文字を読めます。
ほかのツールと「Macの裏技」
- ブラウザで使える無料ツールの一覧:画像・PDF・音声のツールを、1ページに。
- 画像から文字を読み取る:写真やスクショの文字を、コピーできる文に。
- PDFを結合・PDFを分割・PDFを圧縮:PDFをまとめる・分ける・小さくする。
- 文字起こし:録音や動画の声を、文字に。
- Macの「プレビュー」でOCRはできる?:画像の文字のコピーと、PDFへの文字の埋め込み。
- スキャンしたPDFの文字がコピーできない:なぜそうなるのか、どうすれば直るのか。
- ブログ「Macの裏技」の記事一覧:Macで困ったことと、その直し方。
Macのアプリも作っています。縦書きの本や新聞をスキャンしたPDFには、ヨミガエルがあります。縦書きの日本語のPDFに、読む順番どおりに文字を入れるMacアプリです。Apple Silicon 搭載の Mac(M1 以降)、macOS 14(Sonoma)以降で使えます。Intel 搭載の Mac と macOS 13(Ventura)以前では使えません。
このツールで使っている部品
PDFを開く部品に PDF.js 6.4.299(Mozilla・Apache License 2.0)を、文字を読み取る部品に Tesseract.js 7.0.0(Apache License 2.0)と、その言語データ tessdata_fast の日本語(jpn)と英語(eng)(Apache License 2.0)を、手を加えずにそのまま使っています。部品のライセンスと入手先はPDF.js の一覧とTesseract の一覧にあります(PDF.js・Tesseract.js・tessdata_fast)。